Che cos’è l’IA di analisi video
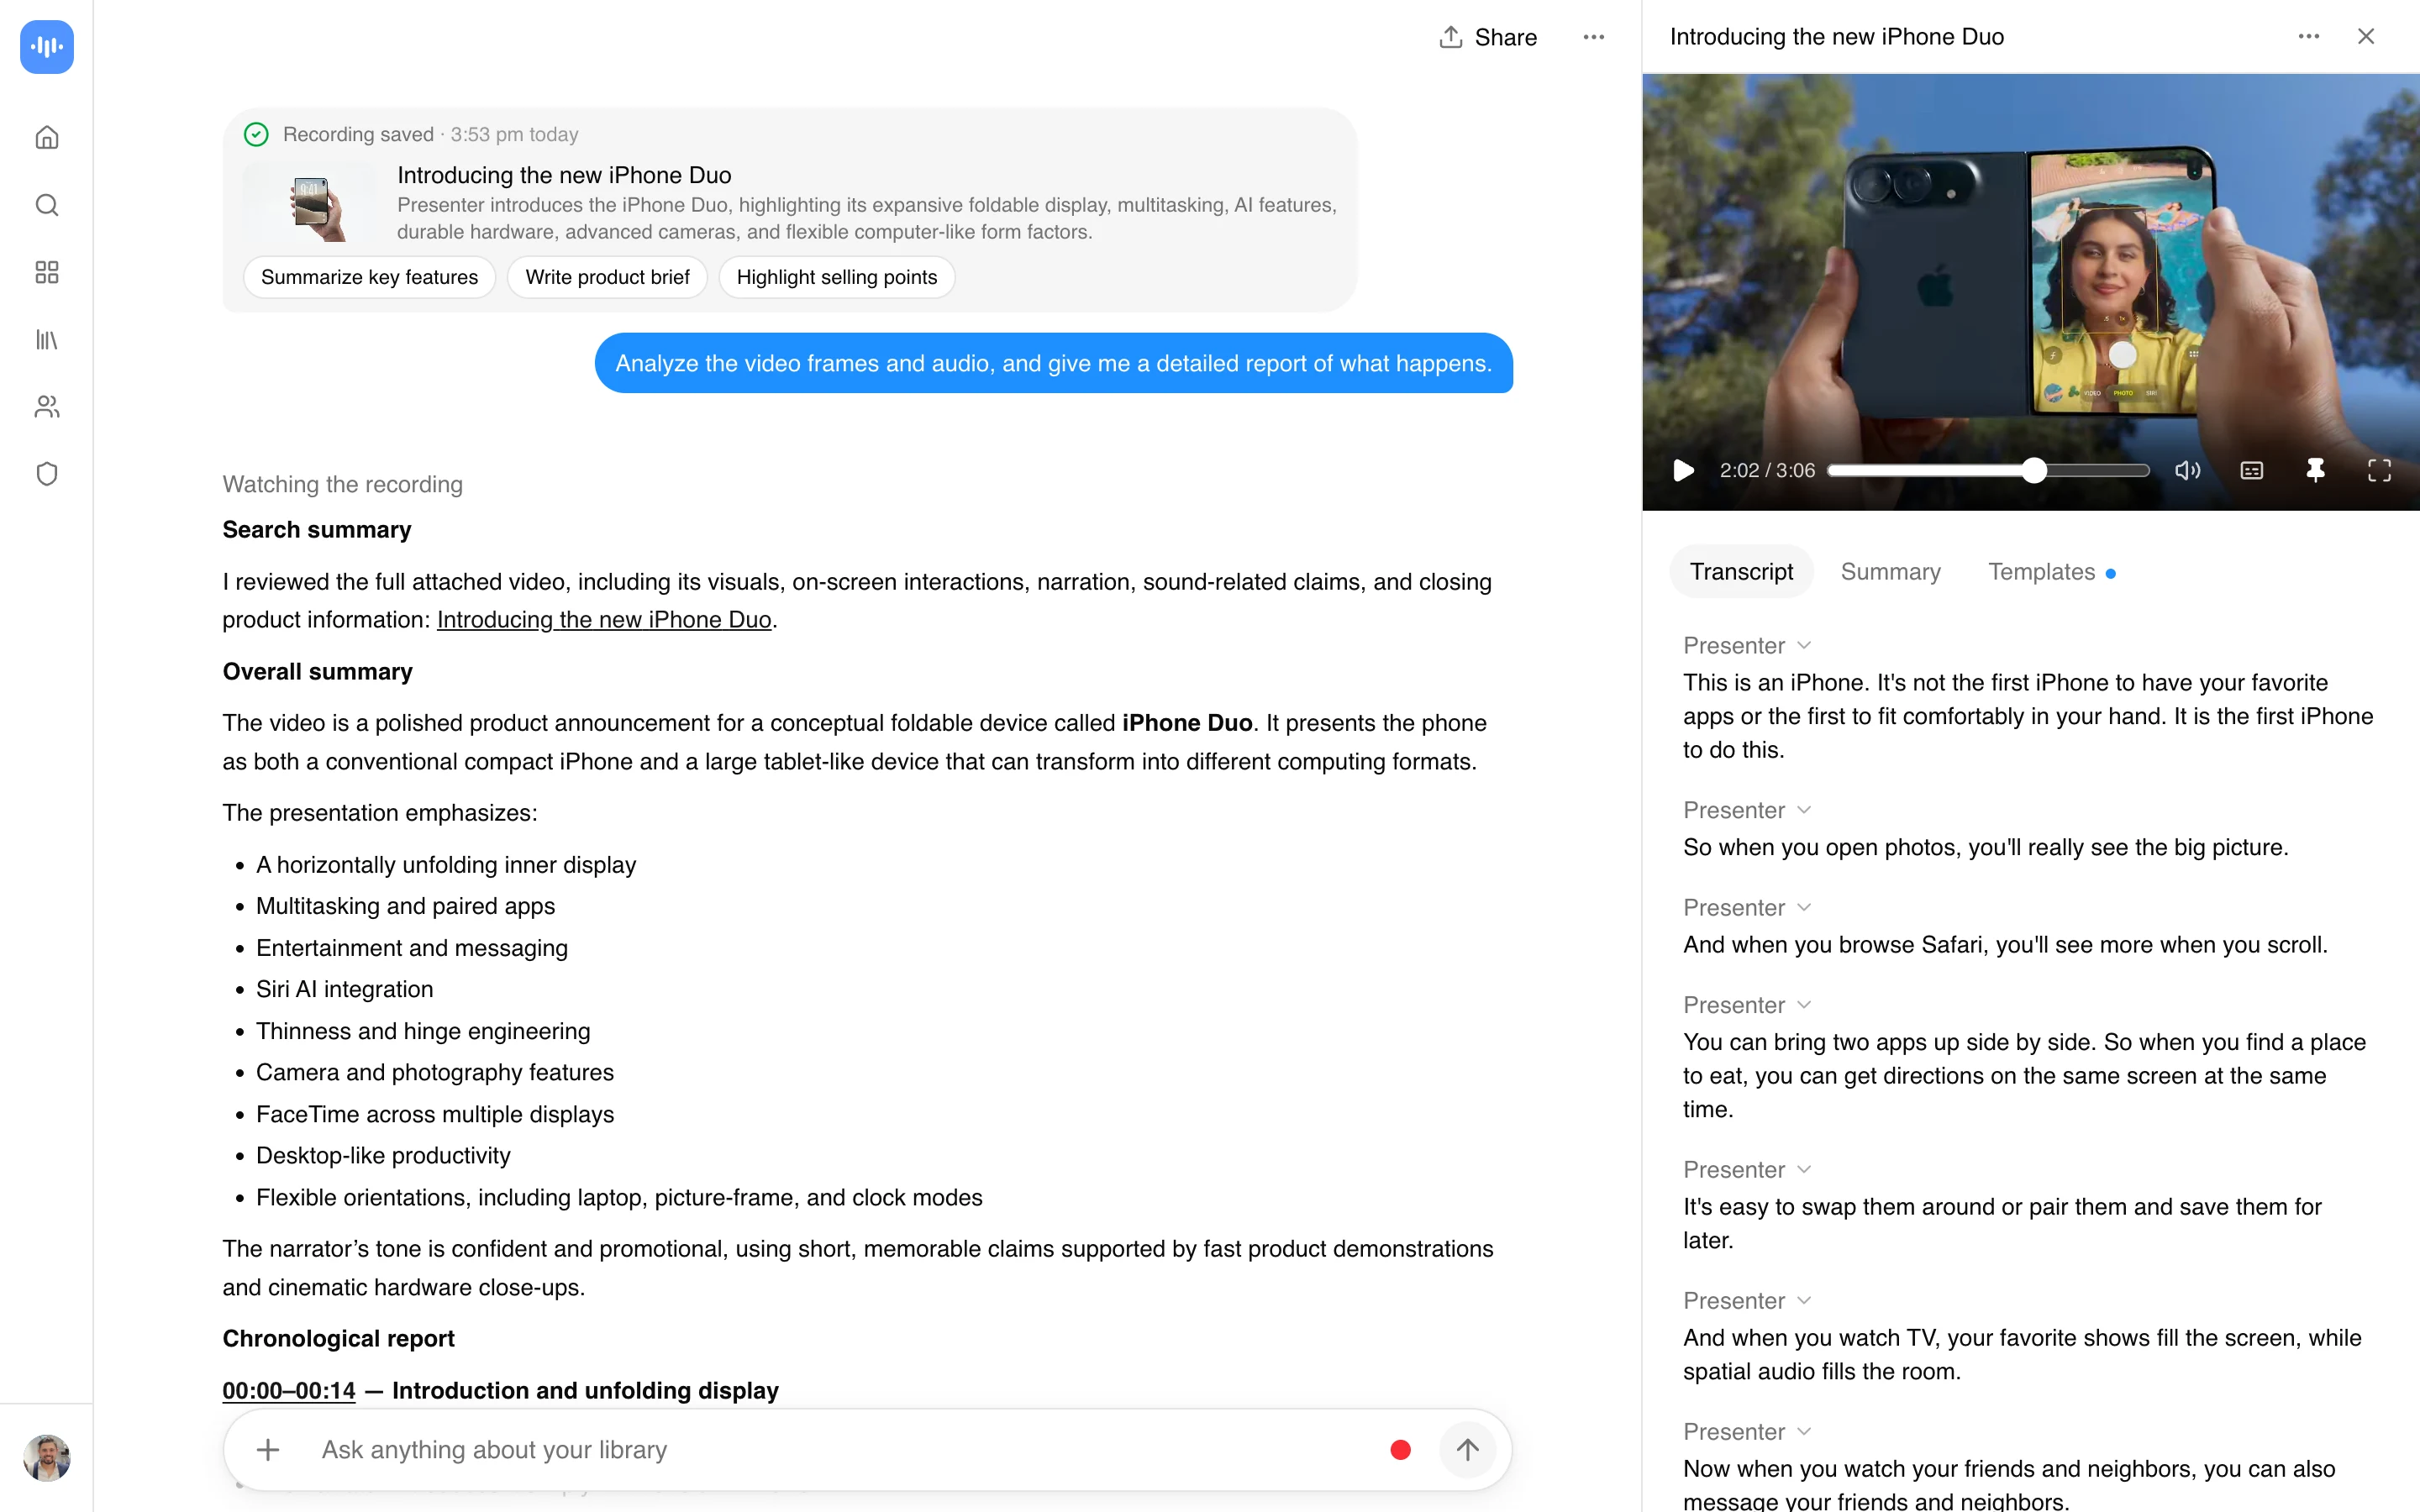
“Analizzare video” qui significa sei operazioni concrete eseguite in un’unica passata: rilevamento di scene con limiti di inquadratura, categorizzazione dei contenuti per argomento, estrazione di momenti chiave legati alle curve di attenzione, analisi del sentimento e dell’argomento dalla traccia parlata, rilevamento di oggetti e volti per fotogramma e OCR per qualsiasi testo sullo schermo. Carica un file o incolla un URL di YouTube, TikTok o Vimeo. Il report restituisce ogni rilevamento legato a un timestamp cliccabile, in modo che un clip di 40 minuti diventi un indice navigabile anziché una visione lineare.
La pipeline esegue la computer vision sulla traccia visiva, il riconoscimento vocale automatico sull’audio e un passaggio OCR sul testo renderizzato, quindi unisce i tre flussi su una singola timeline. I team lo alimentano con filmati di marketing, registrazioni di lezioni, dimostrazioni di prodotti, clip di sorveglianza e creatività dei concorrenti.
Vantaggi dell’Analizzatore Video AI
- Elabora ore di video in minuti. L’analisi automatizzata è molto più veloce rispetto alla visione e alla registrazione manuale del video.
- Rilevamento di scene, oggetti ed emozioni. La visione artificiale etichetta gli elementi visivi fotogramma per fotogramma, mostrando i punteggi di confidenza sottostanti.
- Trascrizioni con timestamp. Riconoscimento vocale con analisi del sentiment e timestamp cliccabili per ogni segmento.
- Estrazione del testo su schermo. L’OCR legge diapositive, lavagne, grafici e sovrapposizioni.
- Segnalazioni sulla qualità del contenuto. L’IA evidenzia problemi di ritmo, cali di attenzione e struttura debole.
- Rapporti esportabili. Scarica PDF, note con timestamp o JSON strutturato.
- Livello gratuito. Un’analisi video all’iscrizione, senza carta di credito. Sblocca l’illimitato tramite la prova Pro di 7 giorni o Pro a $19/mese all’anno.
Come usare l’IA di analisi video
- Carica un file video o incolla un URL di YouTube, TikTok o Vimeo.
- L’IA analizza ogni fotogramma con la computer vision per il rilevamento di oggetti, la classificazione delle scene e il riconoscimento delle emozioni.
- La trascrizione da parlato a testo estrae l’audio con segmenti con timestamp e punteggio del sentimento.
- L’OCR visivo legge il testo sullo schermo da diapositive, lavagne, grafici e sovrapposizioni.
- Ottieni un report dettagliato con analisi delle scene, metriche di coinvolgimento, punteggi di qualità del contenuto e raccomandazioni.
- Esporta o condividi come PDF, note con timestamp o JSON.
L’analizzatore esamina elementi visivi (oggetti, volti, testo, loghi), qualità audio (chiarezza, rumore di fondo, schemi di parlato), struttura del contenuto (ritmo, transizioni, momenti chiave) e segnali di coinvolgimento (cali di attenzione, segmenti di alto valore).
I tuoi video rimangono privati. L’elaborazione avviene su infrastruttura cloud crittografata con conformità GDPR e controlli SOC 2 Tipo 2. I file non vengono mai utilizzati per addestrare modelli AI pubblici e vengono eliminati dopo l’elaborazione, a meno che tu non li salvi.
Rilevamento deepfake: cosa controlliamo realmente
Il rilevamento deepfake è un punteggio di probabilità, non un verdetto. L’analizzatore di ScreenApp esegue sei controlli di segnale indipendenti e li combina in una valutazione di confidenza, con i punteggi sottostanti mostrati in modo da poter vedere quali segnali si sono attivati. Di seguito è riportato lo stack di segnali effettivo e cosa esamina ciascuno di essi.
I sei controlli di segnale
- Consistenza dei fotogrammi: Esamina come l’identità a livello di pixel di un volto si mantiene attraverso fotogrammi consecutivi. I volti reali si deformano in modo fluido; i volti generati da GAN spesso presentano micro-vibrazioni al confine tra sfondo e volto (l’effetto “nuoto”). Confidenza: alta per i primi modelli di diffusione, più bassa per lo stato dell’arte attuale.
- Allineamento labiale (lip-sync): Allinea i fonemi audio con le forme della bocca. Il parlato reale ha una stretta corrispondenza visema-fonema; molti deepfake di face-swap rompono questa corrispondenza entro finestre di 200-400 ms. Rischio di falso positivo: contenuto doppiato (che presenta lo stesso disallineamento per design).
- Impronte spettrali: Cerca impronte digitali della famiglia GAN nel dominio della frequenza. Ogni famiglia di generatori (StyleGAN3, Stable Video Diffusion, Pika, Runway Gen-3, Sora) lascia schemi caratteristici nello spettro ad alta frequenza. Confrontiamo con un catalogo di 14 generatori noti.
- Discontinuità della forma d’onda audio: L’audio clonato vocalmente mostra micro-discontinuità nei punti di concatenazione. Campioniamo la forma d’onda a 24 kHz e cerchiamo picchi di energia incoerenti con i modelli naturali di respiro/pausa.
- Metadati EXIF e del contenitore: Legge i metadati del file per impronte digitali di software di editing (che gli strumenti video AI lasciano nel contenitore) e timestamp di creazione/modifica che non corrispondono alle date di registrazione dichiarate.
- Rilevamento watermark: Scansiona per watermark noti C2PA / SynthID / specifici del fornitore. OpenAI, Google, Meta e Adobe appongono watermark alle loro output generate dall’IA; trovarne uno è un segnale positivo di generazione AI (non necessariamente dannosa, potrebbe essere contenuto AI legittimo).
Come si presenta il punteggio
{
 "verdict": "likely_ai_generated",
 "confidence": 0.84,
 "signals": {
 "frame_consistency": { "score": 0.78, "fired": true },
 "lip_sync_alignment": { "score": 0.41, "fired": false, "note": "audio sembra doppiato; segnale inaffidabile" },
 "spectral_fingerprints": { "score": 0.91, "fired": true, "match": "Sora-2" },
 "waveform_discontinuities": { "score": 0.62, "fired": true },
 "exif_metadata": { "score": 0.55, "fired": false },
 "watermark_detection": { "score": 0.97, "fired": true, "type": "C2PA-OpenAI" }
 },
 "analyzed_at": "2026-05-13T14:22:18Z"
}
Dove è affidabile e dove no
Il rilevamento è più forte sui clip completamente generati dall’IA da generatori noti e più debole dove la normale post-produzione imita artefatti sintetici:
- Più affidabile: clip da generatori AI attuali e precedenti (Sora 2, Veo 3, Runway, Pika iniziale) e filmati standard da smartphone, che raramente vengono falsamente segnalati.
- Più falsi allarmi: video pesantemente post-prodotti (correzione colore, variazioni di velocità, VFX) e filmati ricodificati più volte, perché gli artefatti di compressione possono assomigliare agli artefatti GAN.
Punti deboli noti
- Clip molto brevi sotto i 3 secondi, non abbastanza fotogrammi per l’analisi di consistenza
- Video pesantemente watermarkati o brandizzati (sottotitoli, ID stazione interferiscono)
- Filmati a sorgente mista (introduzione reale + segmento AI + outro reale): l’analizzatore riporta un intervallo di confidenza per capitolo, non un singolo verdetto
- I deepfake solo audio sono valutati separatamente, i controlli visivi non si applicano
Usa il verdetto come un input, non come la conclusione. Abbina l’output dell’analizzatore a controlli di provenienza (da dove proviene questo clip? chi l’ha caricato per primo? corrisponde ad altri filmati dello stesso evento?) prima di pubblicare qualsiasi conclusione.
Chi usa l’IA di analisi video
I team di Ad-ops che misurano la creatività dei concorrenti estraggono annunci TikTok e YouTube da marchi rivali, li eseguono tramite l’analizzatore e ottengono tag per fotogramma per hook, posizionamenti di prodotto, CTA e ritmo. L’output alimenta i brief creativi e le roadmap di test A/B.
Gli analisti di notizie e trasmissioni che taggano i filmati indicizzano registrazioni sul campo e conferenze stampa per oratore, grafici sullo schermo, segnali di posizione e frasi citate. I ricercatori saltano direttamente ai secondi che contengono un argomento specifico invece di scorrere il nastro.
I team di sicurezza del marchio che scansionano i contenuti generati dagli utenti (UGC) rivedono i clip inviati dagli utenti prima che vadano in diretta sulle piattaforme della comunità. Il rilevamento di oggetti segnala armi, proprietà di marca e contenuti non sicuri; l’OCR rileva le sovrapposizioni di testo coperte dalle regole di moderazione; i controlli deepfake segnalano i fotogrammi manipolati.
I team di e-learning che misurano i punti di coinvolgimento correlano i cali di attenzione con specifici segmenti di lezione, quindi identificano quali diapositive, esempi o pause dell’istruttore hanno causato il calo. I team del corso affinano il taglio e testano nuovamente rispetto alle stesse metriche.
Gli analisti della sicurezza e della conformità scansionano la sorveglianza a lungo termine per oggetti o eventi specifici e utilizzano il rilevamento di deepfake per segnalare video sintetici o alterati tramite controlli di coerenza del fotogramma e artefatti audio.
Porre la Domanda Giusta all’Analizzatore
L’analisi è utile solo quanto ciò che gli si chiede di trovare. Una richiesta vaga (analizza questo video) restituisce un rapporto generico, valido per una prima occhiata. Ma lo strumento è molto più utile quando lo si indirizza verso qualcosa di specifico: trova ogni punto in cui viene menzionato il prezzo, elenca le azioni da intraprendere, timestamp ogni volta che il prodotto viene mostrato sullo schermo. Una domanda specifica ottiene una risposta specifica e utilizzabile.
Questa è la differenza rispetto al guardare il video da soli: puoi chiedere di scansionare una cosa per due ore nel tempo che impieghi a leggere un paragrafo. Se la prima risposta manca di contesto, fai una domanda di follow-up anziché rieseguire l’intera analisi; mantiene la trascrizione e i fotogrammi in memoria, quindi la seconda domanda è più veloce e precisa della prima.